Eigene Modell-Architektur
Der einzige Teil von NEVIM, der nichts Nützliches produziert. Er beantwortet eine Frage: Kann ich ein Sprachmodell mit einer selbst ausgedachten Struktur bauen?
Die Frage dahinter
Alle anderen Projekte hier benutzen Sprachmodelle. Dieses stellt eine andere Frage: Kann ich eins selbst bauen — nicht ein vorhandenes nachbauen, sondern mit einer Struktur, die ich mir selbst ausgedacht habe?
Das ist der einzige Teil von NEVIM, der nichts Nützliches produziert. Er beantwortet eine Frage. Das reicht mir als Zweck.
Wie es aufgebaut ist
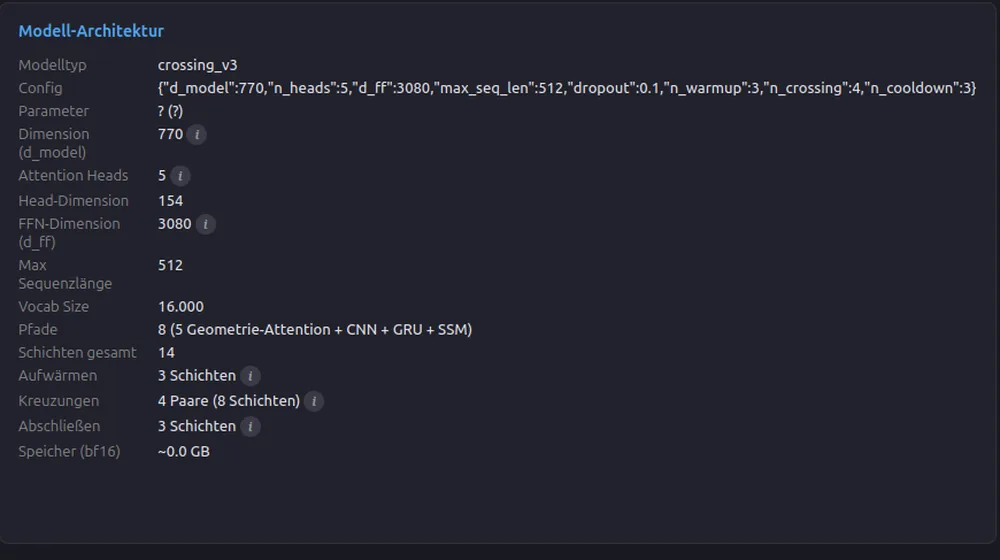
Übliche Sprachmodelle stapeln viele gleichartige Schichten übereinander. Meines hat vierzehn Schichten, aber in jeder liegen acht verschiedene Rechenwege nebeneinander — fünf davon rechnen in unterschiedlichen geometrischen Räumen, drei sind Verfahren anderer Bauart.
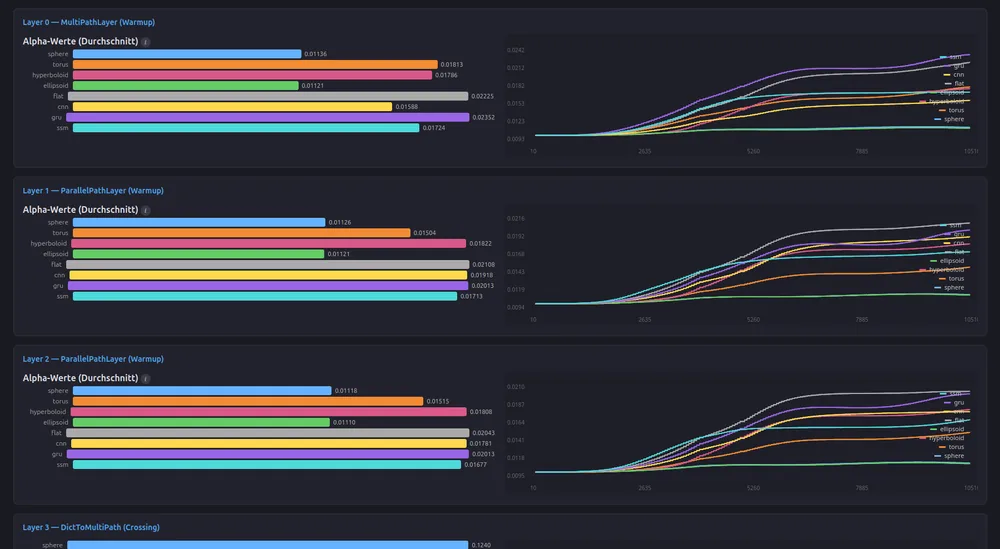
Der Kern der Idee: Die Schicht bekommt nicht vorgeschrieben, welchen Weg sie benutzt. Sie gewichtet selbst, wie stark jeder Weg zum Ergebnis beiträgt, und diese Gewichte verschieben sich beim Lernen. Man kann also hinterher nachsehen, welchen Weg das Modell für welche Aufgabe bevorzugt hat.
Der eigene Wortzerleger
Bevor ein Modell Text lesen kann, muss der Text in Bausteine zerlegt werden. Ich habe die fertigen ausprobiert und wieder verworfen: Sie sind auf Englisch zugeschnitten und zerhacken deutsche Wörter an unsinnigen Stellen — aus Verfassung wurde bei einem so etwas wie „fass" + „ungs". Das Modell muss dann Bruchstücke zusammensetzen, die nie zusammengehört haben.
Also einen eigenen gebaut, mit 16.000 Bausteinen, an deutschem Text gelernt. Gemessen zerlegt er deutschen Text deutlich sparsamer.
Und ein eigenes Trainings-Werkzeug
Das war nicht geplant, wurde aber notwendig. Beim Training will man nicht nur wissen, ob das Modell besser wird, sondern wo. Sonst trainiert man tagelang und merkt am Ende, dass die Hälfte der Schichten gar nichts beigetragen hat.
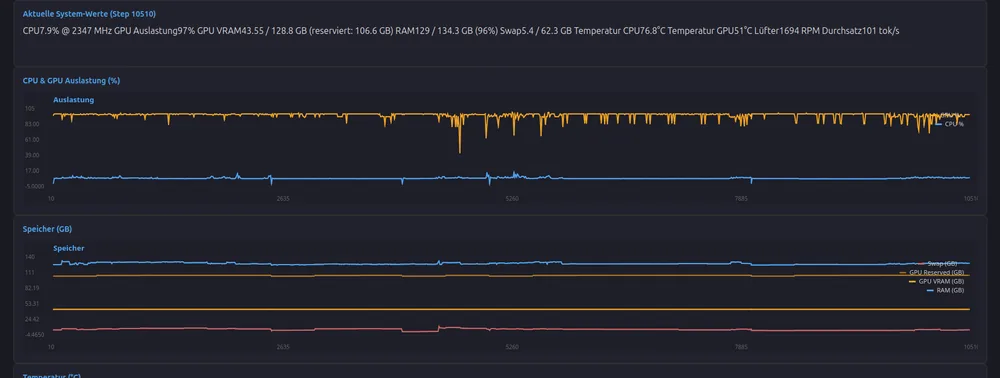
Das Werkzeug misst deshalb für jede einzelne Schicht getrennt, wie gut sie gerade ist und wie stark sie sich verändert — dazu die Gewichtung der acht Rechenwege, die Auslastung des Rechners, Temperaturen und Tempo.
Was dabei herauskam
Das Wichtigste zuerst: Die Tiefe wird genutzt. Die Messung zeigt, dass die späteren Schichten messbar besser abschneiden als die frühen — die Schichten arbeiten also nicht alle dasselbe, sondern bauen aufeinander auf. Genau das war die offene Frage, und bei früheren Versuchen war es nicht so.
Rückblickend war die Ursache damals nicht die Bauweise, sondern das Futter: Die Trainingstexte hatten zu einem großen Teil Formatierungsreste aus ihrer Herkunft — Auszeichnungen, Fußnotenmarken, Rubrik-Angaben mitten im Satz. Nach dem Saubermachen waren es 2,2 Millionen brauchbare Textstücke, und die Schichten fingen an, sich zu unterscheiden.
Und was es nicht kann
Reden. Das Modell erzeugt zusammenhängendes deutsches Gemurmel ohne Inhalt — es hat die Form der Sprache gelernt, aber nicht die Welt dahinter.
Das ist keine Enttäuschung, sondern Arithmetik. Für ein Modell, das wirklich antwortet, bräuchte es ein Vielfaches an Text und ein Vielfaches an Rechenzeit — bei diesem Stand ist erst ein kleiner Bruchteil des geplanten Trainings gelaufen. Der Ertrag dieses Projekts ist die Architektur und das Messwerkzeug, nicht das Modell.
Wie es weitergeht
Im Moment gar nicht. Dieser Strang ruht zugunsten der Projekte, die im Alltag gebraucht werden. Die Architektur steht, das Messwerkzeug steht, die Trainingsdaten liegen aufbereitet bereit — es fehlt die Rechenzeit, und die brauche ich gerade woanders.